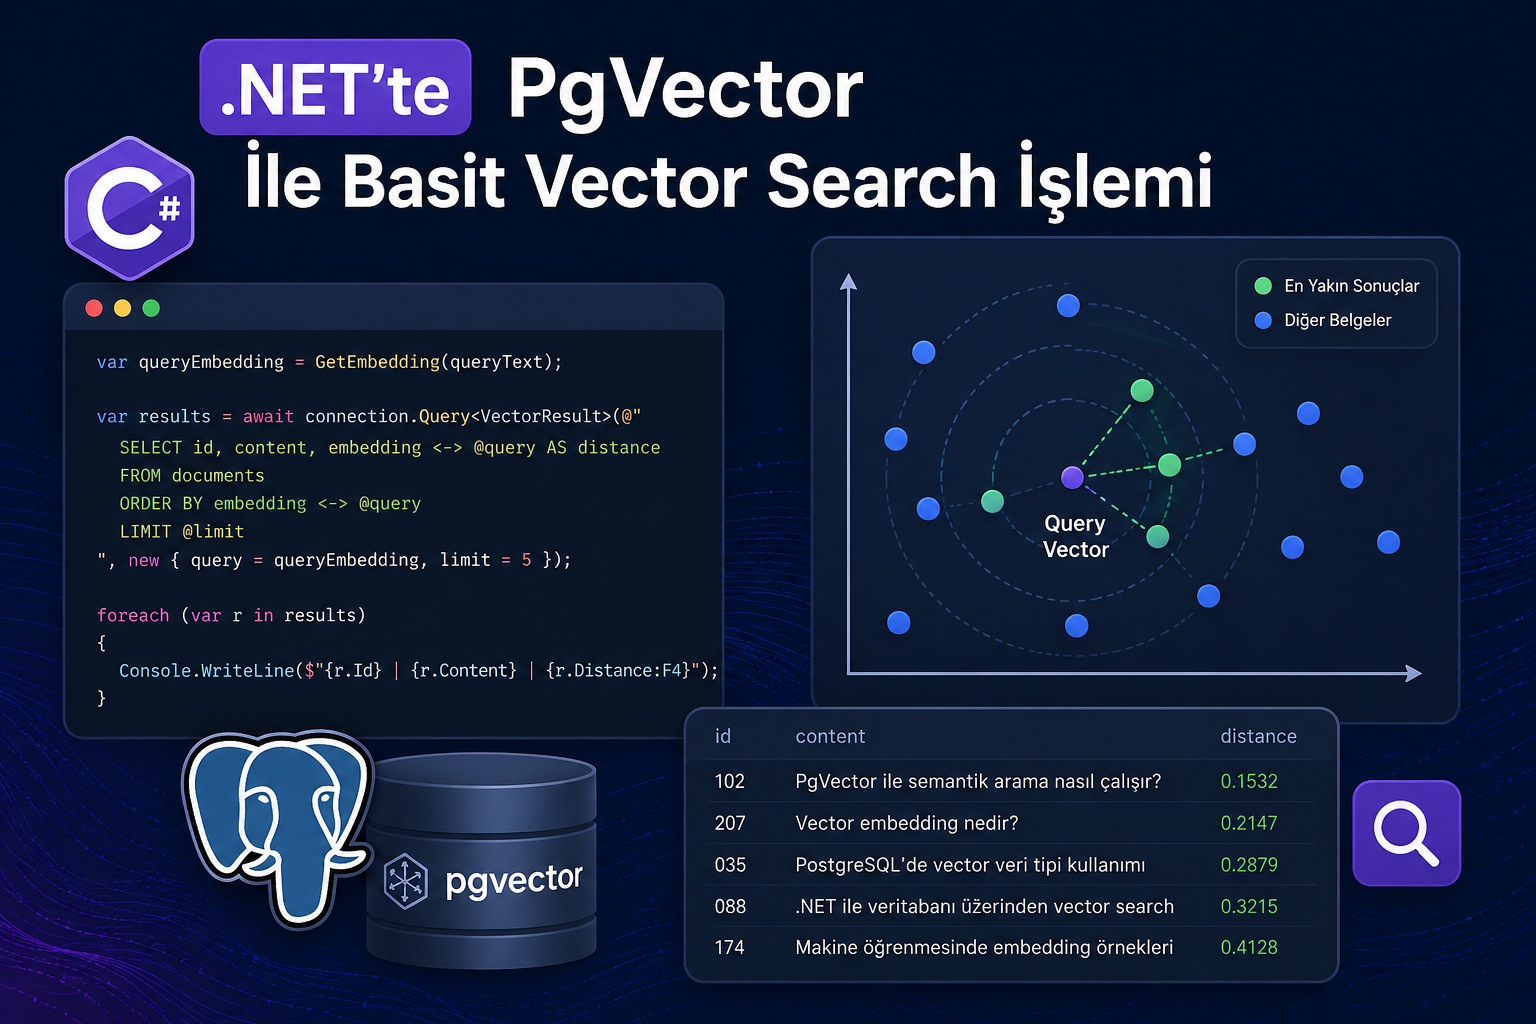
.NET’te PgVector İle Basit Vector Search İşlemi
Merhaba,
Bu içeriğimizde, PostgreSQL veritabanına vektör (embedding) saklama ve benzerlik arama (similarity search) yeteneği kazandıran open source bir eklenti olan PgVector’ü, .NET kapsamında Aspire teknolojisi üzerinden ve Ollama eşliğinde inceleyecek ve deneyimleyeceğiz.
PgVector Ne İşe Yarar?
PgVector, PostgreSQL veritabanını yalnızca verileri saklayan klasik bir veritabanı olmaktan çıkarıp, verilerin anlamlarını da karşılaştırabilen bir yapıya dönüştüren eklentidir. Özellikle yapay zeka uygulamalarında, anlamsal aramaların (semantic search) PostgreSQL ile gerçekleştirilebilmesi için tercih edilmekte ve böylece chatbot’lar da, RAG sistemlerinde, akıllı arama motorlarında veya öneri sistemlerinin büyük kısmında bu amaçla kullanılmaktadır.
Şimdi bu kullanım noktalarına tek tek odaklanırsak eğer;
- Semantic Search (Anlamsal Arama)
PgVector’ün en önemli tarafı bu davranışı PostgreSQL’e kazandırıyor olmasıdır.Normal bir veritabanında, kullanıcı Ankara’nın hava durumuyla ilgili bilgiyi aşağıdaki gibi klasik bir talimatla sorgulayacaktır;
select * from documents
where content like ‘%ankara%’Bu sorgulama, bildiğiniz üzere yalnızca kelime eşleşmesi yapacaktır.
Amma velakin kullanıcı ‘Başkentte hava nasıl?’ diye sorarsa bu klasik yaklaşımla yüksek ihtimalle sonuç gelmeyecektir. Çünkü, insan olarak hepimiz “başkent” denince Ankara’nın kastedildiğini anlıyoruz, ancak bunu klasik SQL ne yazık ki anlamayacaktır 🙂 O sadece karakterlere bakacak, verilerin niceliğiyle ilgilenecektir.
PgVector ise farklı çalışmaktadır… Önce metinlerin anlamını sayısal koordinatlara (embedding) dönüştürecek ve bunlarla vektörel düzlemde bir anlam noktası oluşturacaktır. Devamında ise gelen sorunun da embedding’ini çıkararak bunun en yakın olduğu anlam noktasına göre yakınlık hesaplamasını yapacak ve muhtemel en yakın veriyi cevap olarak döndürecektir. Buna aşağıdaki sorguyu örnek olarak verebiliriz;
select * from documents
order by embedding <=> query_embedding
limit 5;Semantic Search & Vector Search’ü teoride ve pratikte önceden derinlemesine ele aldığım aşağıdaki makalelere göz atmanızı öneririm; - RAG Sistemleri
Semantic Search mantığında olduğu gibi RAG sistemlerinde de önce dokümanlar, PDF’ler ve bilgi depoları embedding’e çevrilir ve ardından PgVector aracılığıyla kaydedilir. Devamında ise kullanıcıdan gelen talebinde embedding’i alınarak PgVector aracılığıyla en alakalı parçalar bulunup, LLM üzerinden nihai cevap üretilmeye çalışılır. - Chatbot Hafızası
PgVector ile geçmiş konuşmalardaki benzer bilgiler rahatlıkla taranabilir. Örneğin, kullanıcı önceden şunları söylemiş olsun:– Ankara’da yaşıyorum.
– Kırmızı araba seviyorum.Yeni konuşmada ise
– Bana uygun araç öner.sorusuna PgVector geçmiş konuşmalardaki benzer bilgileri bulup döndürecektir.
- Öneri Sistemleri
Netflix mantığında olduğu gibi.. Kullanıcının izlediği içerikler vektörleştirilir, ardından benzer içerikler elde edip kullanıcıya tavsiye edilebilir. - Görsel Benzerlik Arama
PgVector ile resimler de embedding’e dönüştürülebilir ve farklı bir resimle benzerlik açısından kıyaslamalara tabi tutulabilir.
PostgreSQL İçin Aspire İle Nasıl Altyapı Sağlanır?
Şimdi PgVector’ü Aspire altyapısıyla nasıl yapılandırabileceğimizi tam teferruatlı bir şekilde inceleyelim istiyorum. Bunun için içeriğimizin ilk satırlarında bahsedildiği gibi Ollama platformundan istifade edeceğiz. Tabi bu platformu bilgisayarımıza kurabileceğimiz gibi docker ortamında da ayağa kaldırabiliriz. Hatta Aspire’daki Ollama (bknz : CommunityToolkit.Aspire.Hosting.Ollama) kütüphanesinden de istifade edebiliriz. Malum… Bizler Aspire ile temelleri atacağımızdan dolayı tüm servislerin sorumluluğunu haliyle Aspire’a verecek ve onun üzerinden yapılandırıyor olacağız. Ayrıca embedding sürecinde Ollama platformu üzerinde ayağa kaldıracağımız qwen3-embedding modelini kullanacağız.
Şimdi bunun için boş bir Aspire projesi oluşturalım ve aşağıdaki adımları sıralı bir şekilde seyrediyor olalım…
- Adım 1 (Aspire Üzerinden Servislerin Kurulumu)
var builder = DistributedApplication.CreateBuilder(args);

var ollama = builder.AddOllama("ollama")
    .WithLifetime(ContainerLifetime.Persistent) // Uygulama dursa bile container ayakta kalır, her seferinde yeniden başlatılmaz
    .WithDataVolume() // Model verileri için kalıcı volume oluşturur, veriler container silinse bile korunur
    .WithGPUSupport(); // GPU hızlandırma desteğini etkinleştirir (varsa)

var embeddingModel = ollama.AddModel("qwen3-embedding");

var postgreSQL = builder.AddPostgres("postgreSQL", port: 6432)
    .WithLifetime(ContainerLifetime.Persistent)
    .WithDataVolume()
    .WithImage("pgvector/pgvector", "pg17")
    .AddDatabase("articles"); // PostgreSQL içinde "articles" adında bir veritabanı oluşturur

builder.AddProject<Projects.Vector_Search_With_PgVector_API>("api")
    .WithReference(embeddingModel)
    .WithReference(postgreSQL)
    .WaitFor(embeddingModel) // API, embedding model hazır olana kadar başlamaz
    .WaitFor(postgreSQL); // API, PostgreSQL hazır olana kadar başlamaz

// Uygulamayı derler ve çalıştırır
builder.Build().Run();
Evet, burada dikkat ederseniz mevzu bahis olan tüm servisler Aspire aracılığıyla ayağa kaldırılmaktadır. Belki dikkatinizi çeken ve izahat gerektiren postgreSQL ile ilgili yapılandırma olabilir. Burada image olarak
pgvector/pgvector‘ün çekildiğini görüyorsunuz. Neden PostgreSQL image’ini değil de bunu çekiyoruz? diye sorarsanız esasında PostgreSQL’i de çektiğimizi bilmenizi isterim.pgvector/pgvector; PostgreSQL’i, PgVector extension’ı ile birlikte getiren bir image’dir. Haliyle buradaki yapılanma esasında şunu ifade etmektedir:pgvector/pgvector:pg17
│ │
│ └── PostgreSQL 17 versiyonunu getir…
└── PgVector extension’ı yüklenmiş olan - Adım 2 (API Yapılandırması)
Şimdi embedding ve vector search süreçlerini tetikleyecek olan bir API projesi oluşturacağız. Bu projede aşağıdaki kütüphaneler yüklü olacaktır;Burada
Pgvector.Dapperkütüphanesi,Vectortürünün Dapper ile sorunsuz şekilde kullanılabilmesi için gerekli type handler bileşenini sunacaktır. Tabi ki de sizler isterseniz Npgsql yahut EF Core kütüphanelerini kullanmayı tercih edebilirsiniz.Şimdi API içerisinde ilgili servisleri aşağıdaki gibi kaydedelim;
.
.
.
builder.AddOllamaApiClient("ollama-qwen3-embedding")
    .AddEmbeddingGenerator();

builder.AddNpgsqlDataSource("articles", configureDataSourceBuilder: builder => builder.UseVector());

SqlMapper.AddTypeHandler(new VectorTypeHandler());
.
.
.
Burada yapılandırmayı tek tek izah etmemiz gerekirse eğer;
- AddOllamaApiClient metodu, Aspire’da tanımlı olan Ollama servisine bağlantı kurmaktadır. Burada ilgili metoda verilen metinsel değer esasında connection string’e karşılık gelmektedir. Aspire, model referansını
{servis-adı}-{model-adı}formatında oluşturduğu için örnekteki gibi isimlendirme yapılmıştır.Ayrıca bu metot ile
OllamaApiClientsınıfı dependency injection için IoC container’ına eklenmektedir. - AddEmbeddingGenerator metodu ise embedding işlemini gerçekleştirecek olan
IEmbeddingGenerator<string, Embedding<float>>servisini IoC container’ına eklemektedir. - AddNpgsqlDataSource metodu ise klasik PostgreSQL bağlantısını IoC container’a eklemektedir. Devamında UseVector metodu ise PgVector desteğini sağlamaktadır.
- SqlMapper.AddTypeHandler metodu ise Dapper ORM’sinin Vector tipini tanıması ve veritabanı işlemlerini kullanması için çağrılmaktadır.
- AddOllamaApiClient metodu, Aspire’da tanımlı olan Ollama servisine bağlantı kurmaktadır. Burada ilgili metoda verilen metinsel değer esasında connection string’e karşılık gelmektedir. Aspire, model referansını
- Adım 3 (Veritabanının Tasarlanıp Oluşturulması ve PgVector’ün Etkinleştirilmesi)
Vector’leri kaydetmeden önce bekleneceği üzere bir tablo oluşturulmalı ve bir yandan da PgVector extension’ının etkileştirilmesi gerekmektedir. Bunun için API projesi içerisinde aşağıdaki sınıfı oluşturalım:public static class DatabaseInitializer { public static async Task InitializeAsync(NpgsqlDataSource npgsqlDataSource) { try { await using var connection = await npgsqlDataSource.OpenConnectionAsync(); await using var command = new NpgsqlCommand("CREATE EXTENSION IF NOT EXISTS vector", connection); await command.ExecuteNonQueryAsync(); await connection.ReloadTypesAsync(); await connection.ExecuteAsync( """ CREATE TABLE IF NOT EXISTS articles ( id SERIAL PRIMARY KEY, title TEXT NOT NULL, url TEXT NOT NULL, content TEXT NOT NULL, embedding VECTOR(1024) NOT NULL, ) """); await connection.ExecuteAsync( """ CREATE INDEX IF NOT EXISTS articles_embedding_idx ON articles USING hnsw (embedding vector_cosine_ops) """); await Console.Out.WriteLineAsync("Database initialized successfully."); } catch { await Console.Out.WriteLineAsync("An error occurred while initializing the database."); } } }Burada tek tanıyamayacağınız komut
CREATE EXTENSION IF NOT EXISTS vectorolsa gerek… İşte bu, PostgreSQL’de PgVector extension’ını etkin kılan SQL talimatımızın ta kendisidir.ReloadTypesAsync metodu ise PostgreSQL’e bilinen türlerin dışında
vectorgibi yeni bir tip eklendiğinde, Npgsql’in bu tipi tanıması için bağlantıyı yenilemektedir. Aksi taktirdevectortipini okuma ve yazma hatası kaçınılmazdır!embedding VECTOR(1024) ifadesine gelirsek eğer vector türünü ifade etmektedir. 1024 ise, kullandığımız
qwen3-embeddingmodelinin 1024 boyutlu vektör üretmesinden kaynaklıdır.vector_cosine_ops komutu ise vektörler arasındaki karşılaştırmanın hangi operatöre göre yapılacağını kararlaştırmaktadır. Haliyle burada Cosine similarity kullanılacağı aşikardır. hnsw‘de Hierarchical Navigable Small World’e karşılık gelen, oldukça hızlı, yaklaşık en yakın komşu araması (ANN) yapan bir algoritmadır.
İndeks OLMADAN (Brute Force): İndeks İLE (HNSW):
┌─────────────────────────┐ ┌─────────────────────────┐
│ Her satırı tek tek │ │ Akıllı graf yapısı │
│ karşılaştır │ │ ile atla atla git │
│ │ │ │
│ 1M satır = 1M işlem 🐢 │ │ 1M satır = ~100 işlem 🚀│
└─────────────────────────┘ └─────────────────────────┘Devamında ise Program.cs dosyasında bu sınıf üzerinden
InitializeAsyncmetodunun aşağıdaki gibi çağırılması gerekmektedir;. . . using var scope = app.Services.CreateScope(); await DatabaseInitializer.InitializeAsync(scope.ServiceProvider.GetRequiredService<NpgsqlDataSource>());
Böylece uygulama ayağa kaldırıldığında hem veritabanı tablosu oluşturulacak hem de PgVector extension’ı etkin kılınacaktır.
- Adım 4 (Embedding Oluşturma ve Veritabanına Kaydetme)
Şimdi de verilerin embedding’lerini oluşturalım ve vector’lerini çıkaralım, ardından bunları verilerle birlikte veritabanına kaydedelim.app.MapGet("/embeddings/generate", async (IEmbeddingGenerator<string, Embedding<float>> embeddingGenerator, NpgsqlDataSource npgsqlDataSource, BlogService blogService, ILogger<Program> logger) => { await using var connection = await npgsqlDataSource.OpenConnectionAsync(); await connection.ReloadTypesAsync(); var urls = await blogService.GetSitemapAsync(); int count = 0; foreach (string url in urls) { var (title, content) = await blogService.GetTitleAndContentAsync(url); var embedding = await embeddingGenerator.GenerateAsync(content); await connection.ExecuteAsync("INSERT INTO articles(title, url, content, embedding) VALUES(@Title, @Url, @Content, @Embedding)", new { Title = title, Url = url, Content = content, Embedding = new Pgvector.Vector(embedding.Vector.ToArray()) }); count++; logger.LogInformation("Processed {count}: {url}", count, url); } });Burada
embeddingGenerator.GenerateAsync(content)ilgili veriyi Ollama’daki modele gönderecek ve embedding’ini oluşturacaktır. - Adım 5 (Cosine Distance İle Similarity Search)
Sırada kosinüs algoritmasıyla benzerlik aramasını gerçekleştirmeye geçebiliriz;app.MapGet("/search", async (string query, IEmbeddingGenerator<string, Embedding<float>> embeddingGenerator, NpgsqlDataSource npgsqlDataSource) => { var searchEmbedding = await embeddingGenerator.GenerateAsync(query); await using var connection = await npgsqlDataSource.OpenConnectionAsync(); await connection.ReloadTypesAsync(); var results = await connection.QueryAsync<dynamic>( """ SELECT id, title, url, content, embedding <=> @Embedding as distance FROM articles ORDER BY embedding <=> @Embedding LIMIT 5 """, new { Embedding = new Pgvector.Vector(searchEmbedding.Vector.ToArray()) }); return TypedResults.Ok(new { query, results = results.Select(r => r.url) }); });Burada dikkat ederseniz
<=>operatörü kullanılmaktadır. Bu operatör, PgVector’ün kosinüs mesafesini ölçümleyebilmek için getirmiş olduğu bir operatördür.Unutmayın! Sorgu metninde kullanılan embedding değerini üreten model ile depolanmış vektörleri üreten model birebir aynı olmalıdır! Aksi taktirde, üretilen embedding değerler farklı vektörel uzaylarda temsil edileceği için bunların karşılaştırılması anlamsız olacaktır.
PgVector’ün desteklediği diğer operatörler ise şunlardır;
<->– L2 (Öklid) mesafesini hesaplar. İki vektör arasındaki doğrusal (kuş uçuşu) uzaklığı ölçer. Mesafe ne kadar küçükse vektörler o kadar benzerdir.<=>– Kosinüs mesafesini hesaplar. Vektörlerin büyüklüğünden ziyade yönlerini karşılaştırır. Özellikle embedding tabanlı semantik benzerlik aramalarında en yaygın kullanılan operatördür. Mesafe ne kadar küçükse benzerlik o kadar yüksektir.<#>– Negatif iç çarpımı (negative inner product) hesaplar. PostgreSQL indekslerinin artan sırada çalışabilmesi için iç çarpımın negatif değeri döndürülür. Maksimum iç çarpımı bulmak istiyorsanız en küçük<#>sonucunu ararsınız. Özellikle embedding’ler normalize edilmişse oldukça hızlı ve etkili bir benzerlik ölçümüdür.
İşte bu kadar… 🙂
Böylece yaptığımız çalışma neticesinde PgVector eşliğinde Vector Search davranışını rahatlıkla uygulayabildiğimizi pratik bir şekilde tecrübe etmiş bulunuyoruz.
Nihai olarak;
İçerik boyunca görüldüğü üzere, uygulamalarımıza anlamsal arama (semantic search) davranışını eklemek için özel bir vektör veritabanına ihtiyacımız bulunmamaktadır. PosgreSQL, PgVector ile yeni bir altyapıya gerek duyulmaksızın vektör depolama ve similarity search davranışını rahatlıkla sağlamaktadır. Üstelik bu yetkinliği, mevcut ilişkisel verilerimizle aynı ortamda, aynı sorgu diliyle ve Dapper/EF Core gibi alışkın olduğumuz araçları kullanarak, operasyonel karmaşıklığı büyük ölçüde azaltarak sağlamaktadır. Bunların yanında Aspire’ın sunduğu orkestrasyon yeteneği sayesinde Ollama ve PostgreSQL altyapısını tek bir merkezden ayağa kaldırabilmekte, HNSW indeksleme ve kosinüs benzerliği gibi güçlü vektör operasyonlarını oldukça hızlı ve tereddütsüz bir şekilde devreye alabilmekteyiz.
Kısacası; PgVector, RAG sistemlerinden chatbot hafızasına, öneri motorlarından görsel benzerlik aramaya kadar geniş bir yelpazede, mevcut PostgreSQL yatırımımızı ziyan etmeden yapay zeka destekli uygulamalar geliştirmemizin en pratik ve sağlam yollarından biri olarak karşımıza çıkmaktadır. Şayet sizler de ekosistemde yeni teknolojiler arayışındaysanız, özellikle mevcut PostgreSQL altyapınızın ne kadar ileriye gidebildiğini PgVector ile bir kez daha değerlendirmenizi tavsiye etmekteyim.
İlgilenenlerin faydalanması dileğiyle…
Sonraki yazılarımda görüşmek üzere…
İyi çalışmalar…